共享方案的性能与故障隔离
多个推理实例共享一张 GPU 时,评估重点是推理性能和故障对其他实例的影响。本文以直接运行 vLLM 的单实例和双实例为基线,对比 HAMi 与基于 NVIDIA MPS 的共享方案,展示各方案的吞吐、响应延迟和故障隔离测试结果。
性能测试在 A100 上运行 Qwen3-4B,故障测试使用 CUDA 测试程序。固定缓存性能测试使用 legacy MPS v2,常规性能测试使用 GPU Fractioning(底层使用了 MPS v3),故障测试直接使用 MPS v3。
测试目的
- 在每卡总并发相同的条件下,比较单实例与双实例的吞吐和延迟,再比较双实例使用 HAMi 或 MPS 时的表现。
- 检查一个 CUDA 进程发生故障时,同卡及另一张卡上的进程能否继续正确计算。
性能表中的「原生」指直接运行 vLLM、未启用 HAMi 或 MPS 的基线配置。单实例每卡运行一个推理实例,双实例每卡运行两个独立 CUDA 进程。原生双实例为共享方案提供相同实例数下的比较基线。
各配置承担相同的每卡总并发,例如总并发 8 时,单实例承担 8,双实例各承担 4。
术语说明
| 术语 | 含义及本次测试中的用法 |
|---|---|
| CUDA kernel | 在 GPU 上执行的计算函数;一次推理会调用多个 kernel。 |
| Graph / CUDA Graph | 将一组 GPU 操作及其依赖关系预先记录,之后重复执行,减少 CPU 逐次提交操作的开销。本文 Graph 指 vLLM 默认执行模式,可使用 CUDA Graph。 |
| Eager | 按执行流程逐次提交计算。本次通过 --enforce-eager 启用,该选项关闭 CUDA Graph 和 vLLM 的编译集成。 |
| MPS(Multi-Process Service) | NVIDIA 的多进程服务,让多个 CUDA 进程通过服务端共享 GPU。legacy MPS v2 与 MPS v3 指不同的控制接口协议。 |
| GPU Fractioning | 配合 KAI Scheduler 使用的 GPU 共享组件;本次使用 0.1.8 发布版的 MPS v3 共享服务。 |
| KV 缓存、前缀缓存 | KV 缓存保存模型已计算的注意力键和值;前缀缓存进一步复用不同请求中相同提示词前缀的 KV 缓存。 |
| TTFT(Time to First Token) | 请求发出到首个 token 返回的等待时间,越低越好。 |
| TPOT(Time per Output Token) | 单个请求生成后续 token 的平均耗时,越低越好。 |
| p50、p99 | p50 表示 50% 的请求耗时不超过该值,p99 表示 99% 的请求耗时不超过该值。本文对各实例的同一分位数求平均。 |
测试结果
- 固定缓存的 Graph 测试中,原生单实例为 628.57、原生双实例为 335.51、HAMi 50% 双实例为 335.87(相对原生双实例 +0.11%)、legacy MPS v2 为 449.36 tokens/s/GPU。
- 常规 Graph 测试的五档并发下,相对原生双实例,HAMi 50% 的吞吐差异为 −0.66%~+2.19%,HAMi 不限算力为 −0.10%~+0.20%;GPU Fractioning 高 25.14%~37.60%。
- 常规 Eager 测试的五档并发下,HAMi 50% 比原生双实例低 4.46%~7.94%;固定缓存 Eager 中低 2.22%。
- 分别注入 GPU 非法写入、异常指令(trap)和计算中强制结束进程三类故障,每类测试两次。使用原生或 HAMi 配置时,同卡健康进程均保持正确输出;使用 MPS v3 的共享或静态分区配置时,同卡健康进程均受影响。
固定缓存里,原生单实例、原生双实例和 legacy MPS 在 A 组,HAMi 50% 在 C 组。常规测试里,原生双实例在 B 组,HAMi 50% 在 C 组,HAMi 不限算力和 GPU Fractioning 在 A 组。跨组相减的百分比同时包含卡的差别和方案的差别,说明见测试条件。
HAMi 2.10 的算力限制加在 kernel launch 上。Eager 关闭 Graph 后,每次 kernel 启动都执行这道检查,再按算力配额和算力限制是否开启决定是否限流。Graph 回放调用 cuGraphLaunch,该版本将调用直接转发给 CUDA 驱动,由驱动执行已录制的计算 Graph,因此 Graph 回放会绕过上述 HAMi 限流路径。
推理性能
「HAMi 50%」指每实例配置 50% 算力配额和 20 GiB 显存配额。同卡两个实例配置的算力配额合计为 100%。
固定缓存对照:每实例 6 GiB
每卡总并发 8,每实例 KV 缓存固定为 6 GiB,关闭前缀缓存;最大模型长度 4096、最大序列数 32。HAMi 每实例算力配额为 50%,MPS 使用 legacy v2;同一次部署测三轮。
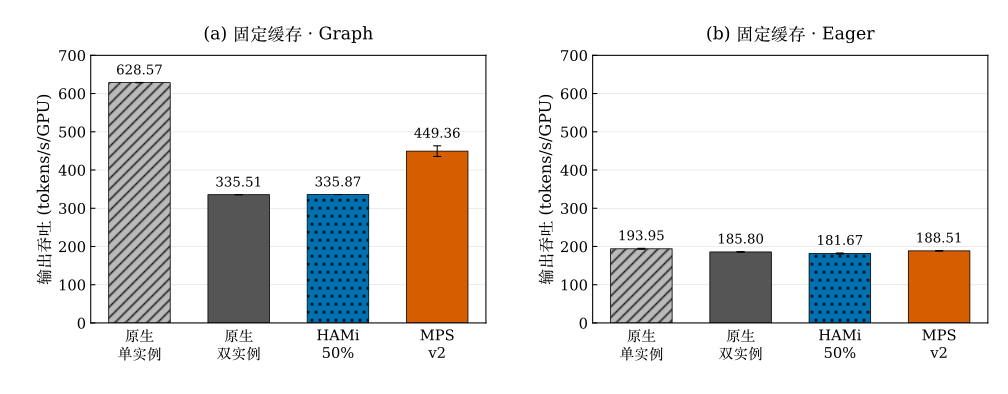
柱形是三轮吞吐均值,柱尾细线覆盖「均值减一个样本标准差」到「均值加一个样本标准差」:线越长,三轮结果波动越大。吞吐单位为输出 tokens/s/GPU,越高越好。
吞吐为三轮均值 ± 样本标准差,延迟单位为 ms。
| 模式 | 配置 | 输出 tokens/s/GPU | TTFT p50 | TTFT p99 | TPOT p50 | TPOT p99 |
|---|---|---|---|---|---|---|
| Graph | 原生单实例 | 628.57 ± 0.30 | 335.46 | 678.19 | 11.42 | 12.02 |
| Graph | 原生双实例 | 335.51 ± 0.02 | 563.53 | 738.61 | 21.71 | 22.40 |
| Graph | HAMi 双实例(50%) | 335.87 ± 0.06 | 558.37 | 729.45 | 21.71 | 22.39 |
| Graph | Legacy MPS 双实例 | 449.36 ± 13.92 | 413.50 | 538.98 | 16.82 | 17.40 |
| Eager | 原生单实例 | 193.95 ± 1.17 | 331.43 | 722.70 | 40.03 | 40.82 |
| Eager | 原生双实例 | 185.80 ± 0.73 | 440.87 | 659.38 | 41.52 | 42.73 |
| Eager | HAMi 双实例(50%) | 181.67 ± 1.32 | 426.37 | 671.97 | 42.54 | 43.68 |
| Eager | Legacy MPS 双实例 | 188.51 ± 0.73 | 311.23 | 500.70 | 41.37 | 42.55 |
吞吐与延迟的统计方式
图和性能表采用「实例吞吐求和」:先计算各实例每秒输出的 token 数,再求和并除以 GPU 数量。
另一种算法按「整个测试时段」计算:全部实例输出的 token 总数,除以最早开始到最晚结束的总时长,再除以 GPU 数量。实例测量时段未完全重叠时,两种结果会不同。Legacy MPS 的结果如下:
| 模式 | 实例吞吐求和(tokens/s/GPU) | 整个测试时段(tokens/s/GPU) |
|---|---|---|
| Graph | 449.36 | 399.28 |
| Eager | 188.51 | 187.29 |
按整个测试时段计算,Graph 原生双实例为 334.50,HAMi 50% 为 334.97 tokens/s/GPU;比较时应使用同一种算法。
延迟先分别平均各实例的 p50、p99,再平均三轮结果。
固定缓存数据 · 未启用算力限制的参考数据 · 50% 算力逐轮结果。
常规测试:自动分配缓存
通过 Dynamo 运行 vLLM,用官方 run-sweep.sh 压测,自动分配 KV 缓存并使用默认前缀缓存,各配置测一轮。
每卡并发 2 和 4 时,前缀缓存读取比例为:原生单实例 99.61%,所有双实例配置均为 0%。每卡并发 8 时,两者分别为 49.81% 和 0%。五档并发的完整比例见常规测试 CSV。因此,单、双实例的差异也包含缓存复用的影响;固定缓存测试已关闭前缀缓存。
每卡总并发为 2、4、8、16、32,除原生单实例外均为双实例;HAMi 两种配置均为每实例 20 GiB 显存配额。吞吐单位为输出 tokens/s/GPU;粗体为该档最高值,括号为相对原生双实例的差异。
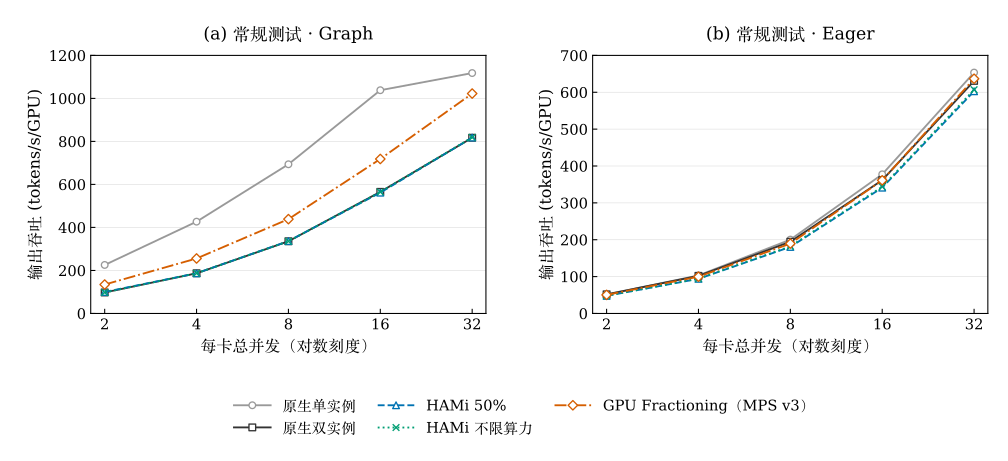
每条折线是一种配置,每个点是该配置在某一档并发下测得的一轮吞吐,包含 GPU Fractioning 和 HAMi 不限算力。越高越好。
Graph(默认)
| 每卡并发 | 原生单实例 | 原生双实例 | HAMi 50% | HAMi 不限算力 | GPU Fractioning |
|---|---|---|---|---|---|
| 2 | 225.50 | 97.66 | 99.80(+2.19%) | 97.61(−0.05%) | 134.37(+37.60%) |
| 4 | 426.82 | 186.77 | 186.92(+0.08%) | 186.76(0.00%) | 255.64(+36.88%) |
| 8 | 693.67 | 335.67 | 336.52(+0.25%) | 335.62(−0.02%) | 438.59(+30.66%) |
| 16 | 1038.10 | 565.45 | 561.73(−0.66%) | 564.90(−0.10%) | 718.28(+27.03%) |
| 32 | 1117.88 | 817.12 | 817.89(+0.10%) | 818.71(+0.20%) | 1022.54(+25.14%) |
Eager
| 每卡并发 | 原生单实例 | 原生双实例 | HAMi 50% | HAMi 不限算力 | GPU Fractioning |
|---|---|---|---|---|---|
| 2 | 51.26 | 51.84 | 47.76(−7.88%) | 48.11(−7.20%) | 50.34(−2.91%) |
| 4 | 103.10 | 101.99 | 93.89(−7.94%) | 94.42(−7.42%) | 99.66(−2.29%) |
| 8 | 200.28 | 194.53 | 180.49(−7.21%) | 182.01(−6.44%) | 189.54(−2.57%) |
| 16 | 377.41 | 361.61 | 341.28(−5.62%) | 343.67(−4.96%) | 361.11(−0.14%) |
| 32 | 653.43 | 630.84 | 602.68(−4.46%) | 606.86(−3.80%) | 636.66(+0.92%) |
五档并发的吞吐差异:
- HAMi 50%(Graph):相对原生双实例,吞吐差异为 −0.66%~+2.19%。
- GPU Fractioning:Graph 高于原生双实例 25.14%~37.60%;Eager 差异为 −2.91%~+0.92%。
- HAMi(Eager):相对原生双实例,50% 配置低 4.46%~7.94%,不限算力配置低 3.80%~7.42%。
响应延迟:每卡并发 8
下表为各实例 p99 的均值,单位 ms。
| 配置 | Graph 首 token | Graph 后续 token | Eager 首 token | Eager 后续 token |
|---|---|---|---|---|
| 原生单实例 | 665.76 | 11.95 | 730.71 | 40.39 |
| 原生双实例 | 730.35 | 22.44 | 669.55 | 40.83 |
| HAMi 50% | 714.99 | 22.41 | 588.04 | 44.52 |
| HAMi 不限算力 | 739.09 | 22.43 | 599.89 | 43.90 |
| GPU Fractioning | 427.74 | 17.48 | 595.79 | 42.67 |
相对原生双实例,HAMi 50% 在 Eager 下的首 token p99 较低,后续每 token 耗时的 p99 较高。
故障隔离结果
同卡运行故障进程和健康进程,另一张 GPU 运行健康对照进程;健康进程重放 CUDA Graph 并校验输出。每项测两次,观察故障前 3 秒、后至少 6 秒。
故障测试使用 HAMi 不限算力配置,每实例显存配额为 20 GiB。MPS v3 分别测试共享和静态分区配置,共享配置启用 memacct、context-share。
2/2 表示同卡健康进程两次均保持正确结果,0/2 表示两次均受影响。
| 注入事件 | 原生多进程 | HAMi 多进程 | MPS v3 共享 | MPS v3 所测静态配置 |
|---|---|---|---|---|
| 超额显存申请 | 2/2 | 2/2 | 2/2 | 2/2 |
| GPU 非法写入 | 2/2 | 2/2 | 0/2 | 0/2 |
| GPU 异常指令(trap) | 2/2 | 2/2 | 0/2 | 0/2 |
| 计算中强制结束进程(SIGKILL) | 2/2 | 2/2 | 0/2 | 0/2 |
| 安全终止 MPS 客户端 | 不适用 | 不适用 | 2/2 | 2/2 |
36 次异卡对照均正常。超额显存用例申请可见容量的两倍,申请均被拒绝。故障计数、错误码与最大采样间隔(CSV)。
静态配置的两个同卡客户端各报告 54 个流式多处理器(SM),分区 ID 不同。机制说明见 MPS 故障处理和静态分区。
测试条件
硬件为 2× A100-SXM4-40GB。软件版本:Ubuntu 24.04.5、NVIDIA 驱动 615.71.10、Dynamo 1.6.1、vLLM 0.31.0、AIPerf 0.13.0。模型为 Qwen3-4B,BF16,每个实例使用一张 GPU;输入 2,048 tokens,输出 256 tokens。
A、B、C 都是 2 张 A100-SXM4-40GB,各自是不同的一对物理卡。同一字母是同一对卡。同型号的卡性能会有差别,跨组相减得到的百分比里,同时有卡的差别和方案的差别。各测试所用的组和日期如下。
| 测试 | 配置 | GPU 组 | 采集日期(UTC) |
|---|---|---|---|
| 固定缓存 | 原生单实例 | A | 2026-11-03 |
| 固定缓存 | 原生双实例 | A | 2026-11-03 |
| 固定缓存 | legacy MPS | A | 2026-11-03 |
| 固定缓存 | HAMi 不限算力 | A | 2026-11-03 |
| 固定缓存 | HAMi 50% | C | 2026-11-05 |
| 常规测试 | 原生单实例 | A | 2026-11-02 |
| 常规测试 | 原生双实例 | B | 2026-11-04 |
| 常规测试 | HAMi 50% | C | 2026-11-05 |
| 常规测试 | HAMi 不限算力 | A | 2026-11-02 |
| 常规测试 | GPU Fractioning | A | 2026-11-02 |
| 故障测试 | 原生、HAMi 不限算力、MPS v3 共享、MPS v3 静态分区 | B | 2026-11-04 |
常规性能测试的部署配置如下。固定缓存的 legacy MPS v2 和故障测试的 MPS v3 配置见对应小节。
| 部署方式 | 每卡实例数 | 显存配置 | 执行配置 |
|---|---|---|---|
| 原生单实例 | 1 | 可见整卡显存 | 独立 CUDA 进程 |
| 原生双实例 | 2 | 每实例引擎显存利用率 0.45 | 独立 CUDA 进程;不使用 HAMi 或 MPS |
| HAMi 2.10.0 双实例 | 2 | 每实例 20 GiB 配额 | 每实例 50% 算力配额 |
| HAMi 2.10.0 双实例(不限算力) | 2 | 每实例 20 GiB 配额 | 关闭算力限制 |
| KAI 0.18.6 + GPU Fractioning 0.1.8 双实例 | 2 | 每实例 20 GiB 配额 | MPS v3 sm-sharing;未启用静态 SM 分区 |
本次使用 GPU Fractioning v0.1.8 发布版的共享 MPS。NVIDIA 报告使用 nv-kmcgill53 维护的 KAI-Scheduler 和 GPU Fractioning 修改版,分支名均为 kmcgill/sm-sharing-main,为每个容器创建独立的 MPS 命名空间并设置算力和显存配额。
复现脚本
汇总数据:常规测试 CSV · 不限算力参考 CSV。
结论
共享方案是否值得推荐,取决于 NVIDIA 容器化 GPU 虚拟化的帕累托前沿。这条前沿尚未测出,本文不推荐任何方案。
