设计:通过配置文件下发 GPU 限制
摘要
HAMi 通过环境变量把 GPU 限制传给 HAMi-core。从新的登录会话(SSH、su -、sudo、cron)启动的进程没有这些变量,运行时不受任何限制。本设计增加一个限制文件:device plugin 把限制写入文件,并以只读方式挂载到容器中,HAMi-core 在其他步骤之前先读取它。默认使用该文件。开关 limitDelivery 可以恢复为通过环境变量下发。
跟踪 issue:#2125。最初的报告:#1112、#1090。
动机
目前限制如何传到 HAMi-core
在 Allocate() 中,device plugin 会在容器上设置以下变量:
| 变量 | 示例 | 含义 |
|---|---|---|
CUDA_DEVICE_MEMORY_LIMIT_<i> | 3000m | 每个已分配设备的显存限制 |
CUDA_DEVICE_SM_LIMIT | 50 | 算力限制 |
CUDA_DEVICE_MEMORY_SHARED_CACHE | /usr/local/vgpu/<uuid>.cache | Pod 内各进程记录用量的共享区 |
libvgpu.so 本身通过文件 /etc/ld.so.preload 加载。这个库会进入每个进程,只有限制的取值通过环境变量传递。
取值在哪里丢失
环境变量属于单个进程,并会复制给它的子进程。登录会话不是入口进程的子进程:sshd、su -、sudo 和 cron 都会从头构建新的环境。
| 进程的启动方式 | 是否有这些变量 |
|---|---|
入口进程及其子进程、bash -c、&、kubectl exec | 有 |
SSH 登录、su -、sudo、login、cron | 没有 |
没有这些变量时,HAMi-core 会退回到私有的 /tmp/cudevshr.cache,并把限制记为 0,即不限制。这个进程既不受限制,也不计入 Pod 的用量。
在当前版本上复现
Kubernetes v1.35.9、containerd 2.3.4、NVIDIA 驱动 550.90.07、CUDA 12.4、NVIDIA A16-16Q,HAMi 使用当前的 Helm chart,Pod 镜像为 nvidia/cuda:12.4.1-devel-ubuntu22.04,nvidia.com/gpumem: 3000。测试程序用 cudaMalloc 申请 4096 MiB。
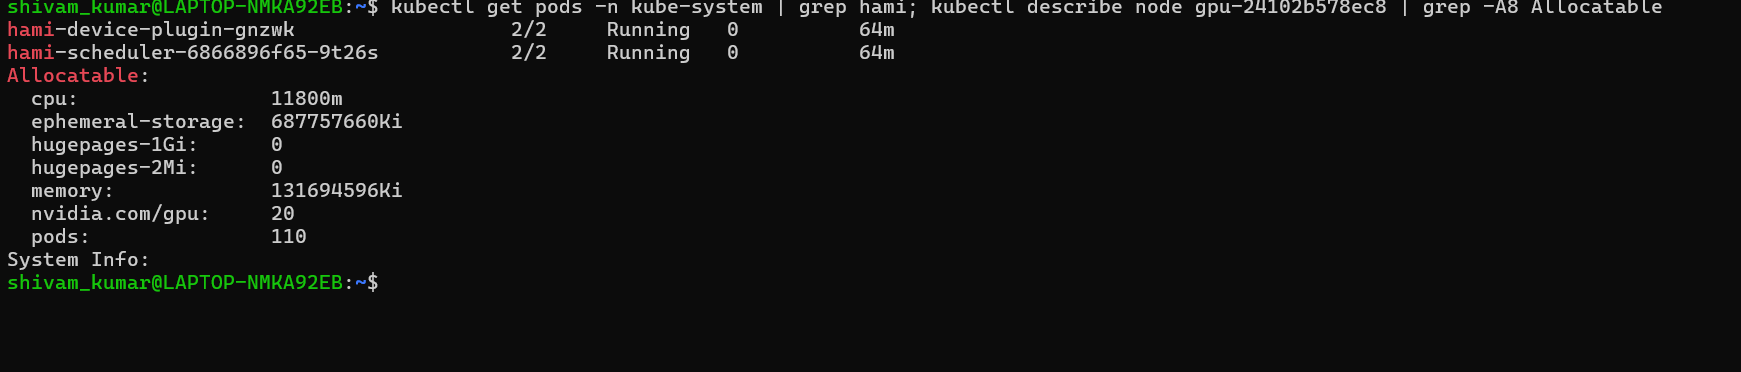
通过 kubectl exec 进入时,变量存在,nvidia-smi 显示 3000 MiB,申请被拒绝:
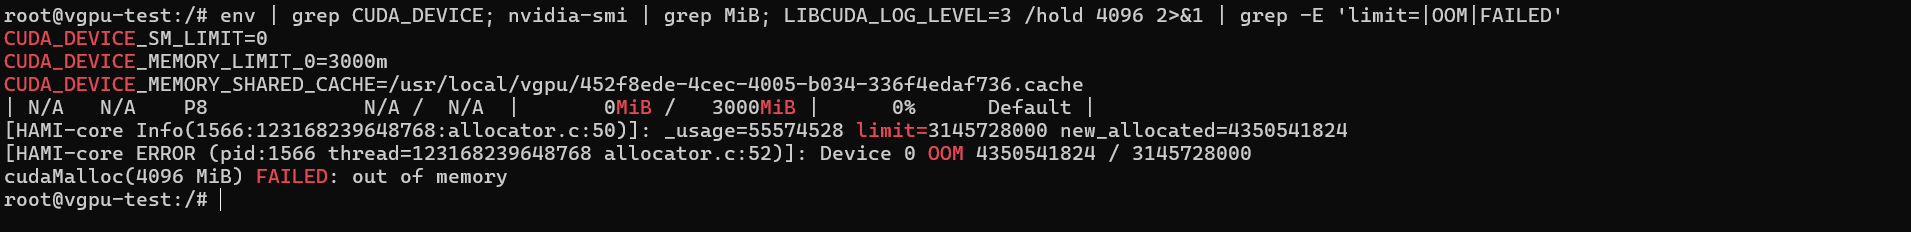
在同一个 Pod 中通过 SSH 登录时,变量消失,nvidia-smi 显示 16384 MiB,同样的申请成功。库本身会在日志中记录退回到 /tmp/cudevshr.cache:
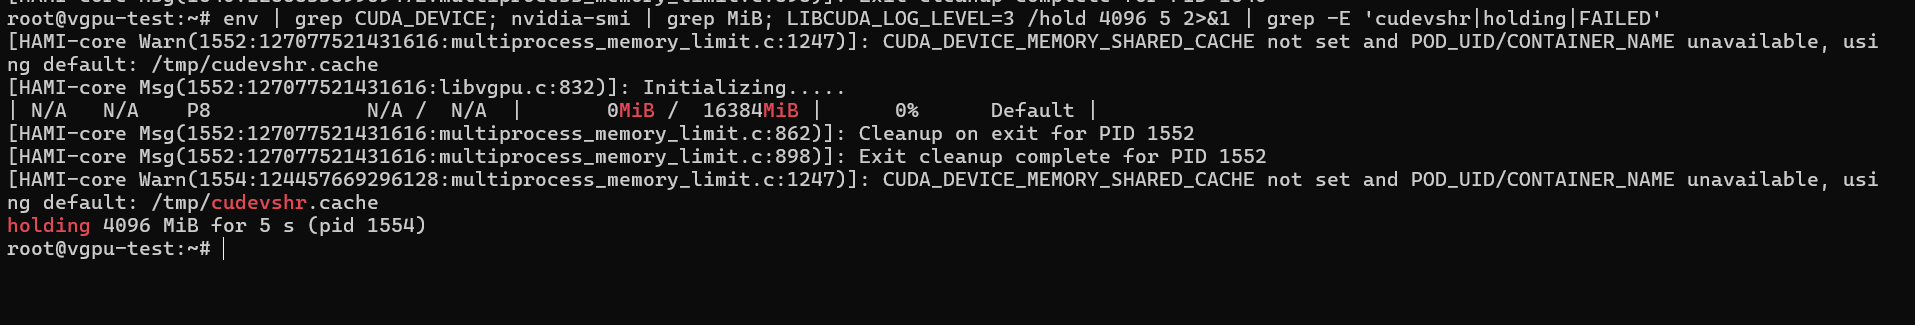
不用 SSH 也是同样的结果:su -(全新环境)获得了 4 GiB,su(保留环境)被拒绝。
在 /overrideEnv 放一个写有正确限制的文件,在已部署的库上并不能改变结果:这个文件只在 NVML 路径上读取,而此时共享区已经写好了限制。因此关键在于何时读取这个文件,只有文件存在还不够。
决定
通过挂载的配置文件下发取值,并将其设为默认,环境变量下发保留为一个开关。环境变量模式不负责覆盖登录会话,需要这一点的运维人员使用默认模式。
已有方案
HAMi#3063 和 HAMi-core#332(已关闭)提出过同样的机制:在缓存目录旁为每个容器生成一个文件,以只读方式挂载到 /overrideEnv,在 initialized() 开始时加载,写入失败时分配失败,CUDA_TASK_PRIORITY 和 GPU_CORE_UTILIZATION_POLICY 取自容器 spec。本设计在此基础上增加了 limitDelivery 开关和回滚路径、文件的原子发布、随已删除 Pod 的目录一起回收文件、不会因一行错误而停止的读取器,以及下面的兼容性一节。
目标
- 容器内的每个进程,无论如何启动,都获得相同的限制。
- 下发过程不依赖进程的环境变量,文件的位置也不依赖。
- 文件不能在容器内被修改。
- 新旧版本的 device plugin 和 HAMi-core 可以混合使用,不会出现回退。
不在本设计范围内、单独跟踪的问题:携带不同限制的进程之间的冲突(目前共享区以第一个写入者为准),以及防止容器内的进程修改共享区。
方案
限制文件
每行一个 KEY=VALUE,键按顺序排列,没有注释,没有空行:
CUDA_DEVICE_MEMORY_LIMIT_0=3000m
CUDA_DEVICE_MEMORY_SHARED_CACHE=/usr/local/vgpu/usage.cache
CUDA_DEVICE_SM_LIMIT=50
HAMI_LIMITS_FORMAT=1
文件包含 HAMi-core 读取的所有变量,其中包括共享缓存路径(没有它,进程会针对一个私有文件执行限制,Pod 的用量统计也看不到这个进程),以及设置了时的 CUDA_OVERSUBSCRIBE、GPU_CORE_UTILIZATION_POLICY、LIBCUDA_LOG_LEVEL、LIBVGPU_HOSTPID_BROKER。它还包含 webhook 在容器 spec 中设置的 CUDA_TASK_PRIORITY 和 GPU_CORE_UTILIZATION_POLICY。HAMI_LIMITS_FORMAT 让以后的读取器能识别旧版或新版的文件。这个格式是 HAMi-core 的 load_env_from_file() 目前能读取的子集:遇到第一行没有 = 的内容就会停止,而插件写出的文件不包含这样的行。使用 JSON 会在一个加载进节点上每个进程的库里增加解析器。
下发模式
devices:
  nvidia:
    limitDelivery: file # 默认值,设为 "env" 恢复为通过环境变量下发
| 模式 | Device plugin | HAMi-core |
|---|---|---|
file(默认) | 写入并挂载文件,同时仍注入环境变量 | 先读取文件,再读取环境变量 |
env | 只注入环境变量 | 与之前一样读取环境变量 |
HAMi-core 没有模式之分:文件存在时读取文件,否则读取环境变量。开关在 device plugin 中,配置在设备配置(nvidia.limitDelivery)里,可以在插件的 config.json 中按节点覆盖,也可以用 hami.io/limit-delivery: "env" 或 "file" 按 Pod 覆盖。生效顺序:Pod 注解、节点配置、全局配置、默认值 file。
固定的共享缓存名称
共享缓存改名为 usage.cache,不再使用随机 UUID。每个容器在主机上的目录本来就是唯一的,并且每次分配都会重新创建,所以随机名称没有作用,而固定的名称可以预先写进文件。vGPU monitor 按 .cache 后缀匹配,不受影响。
设计细节
位置与挂载
| 路径 | 权限 | |
|---|---|---|
| 主机 | <HOOK_PATH>/vgpu/containers/<podUID>_<containerName>.limits | 属主为 root,0644 |
| 容器 | /overrideEnv | 只读的单文件 bind mount |
主机上的文件放在每个容器目录的旁边。这个目录以读写方式挂载在容器中,而只读 bind mount 只保护它自己的挂载点,所以文件不能放进这个目录。容器内的路径编译在 libvgpu.so 中(ENV_OVERRIDE_FILE,从第一个 commit 起就会读取),不会通过环境变量传递,因为登录会话丢失的正是环境变量。
Device plugin
在 Allocate() 中,等容器的环境变量和挂载都确定之后,仅在 file 模式下执行:挑出 HAMi-core 读取的变量,排序后写入临时文件,执行 fsync 和 chmod 0644,再 rename 覆盖最终文件名(被截断的 CUDA_DEVICE_MEMORY_LIMIT_0=30 会被读成 30 字节),然后添加一个到 /overrideEnv 的只读挂载。写入失败会让分配失败:无法下发的限制不能变成没有限制。在 MIG 模式下,插件不注入这些变量,也不挂载 libvgpu.so 和 /etc/ld.so.preload,所以既不写文件,也不添加挂载。vGPU monitor 会在删除已结束 Pod 的目录时一并删除 .limits 文件。
HAMi-core
- 在初始化开始时读取文件,此时还没有选定共享区,也还没有写入限制。CUDA 和 NVML 两个入口都经过同一个初始化过程。
- 文件中的值覆盖环境变量中的值。在
file模式下,文件是唯一可信的来源。在env模式下没有文件。 - 修改
load_env_from_file():目前它遇到第一行没有=的内容就会停止。改为记录这一行及其行号并跳过,这样手动编辑的文件中有一行错误时,不会丢弃其后的内容,包括缓存路径。 - 文件不存在时以 INFO 级别记录日志并使用环境变量,因此直接使用 Docker 以及
env模式的行为不变。
故障行为
| 情况 | Device plugin | HAMi-core |
|---|---|---|
env 模式 | 不写文件,不挂载 | 只使用环境变量 |
| MIG 模式 | 不注入变量,不写文件,不挂载 | 没有可读取的内容 |
| 文件不存在(旧版插件、直接使用 Docker) | — | INFO 日志,只使用环境变量 |
| 文件无法写入 | 分配失败 | Pod 不会在没有限制的情况下启动 |
| 格式错误的行 | 不会写出 | ERROR 日志并带行号,跳过该行 |
| 没有环境变量的进程 | — | 读取文件,带着限制加入 usage.cache |
不存在文件存在却没有产生限制的情况。
兼容性
在 file 模式下仍会注入环境变量,所以任何组合都不会出现回退。新版 HAMi-core 搭配旧版插件时找不到文件,行为与现在相同。旧版 HAMi-core 搭配新版插件时确实会读取文件,但只在 nvml_preInit() 中读取,此时 ensure_initialized() 已经创建了共享区:对入口进程来说,文件内容与环境变量相同,没有变化。对登录会话来说,读取文件之前限制仍然被设为 0,所以限制的执行情况不变(已在上面的复现中验证)。只有在 file 模式下的新版插件搭配新版 HAMi-core 时行为才会改变,而且只影响之前没有限制的进程。正在运行的 Pod 在重建之前保持原有的分配。
安全考虑
文件属主为 root,权限为 0644,在容器内只能通过只读挂载看到,也无法通过可读写的缓存目录访问。本设计解决的是丢失环境变量的进程的正确性问题,并不阻止容器内的进程写入共享区,这一点单独跟踪。
实施计划
- HAMi-core: 在初始化开始时读取文件,实现容错的读取器,并编写测试。这一步可以单独使用。
- HAMi device plugin: 限制文件的写入、只读挂载、
usage.cache,以及单元测试。 - HAMi 配置:
limitDelivery字段、按节点覆盖、Pod 注解、Helm values,以及 monitor 清理。 - 端到端测试和文档:
kubectl exec、bash -c、su -、sudo、SSH、cron。配置参考文档,以及env模式的迁移说明。
上线与回滚
上线:升级 device plugin(默认 file,也可以全局设为 env,只在一个灰度节点上设为 file),升级 HAMi-core,重建选定的工作负载,在 SSH 会话中验证一次分配。回滚:设置 limitDelivery: env,等待插件滚动更新完成,再重建工作负载。没有文件时,新版 HAMi-core 的行为与之前相同。
已知限制
LIBCUDA_LOG_LEVEL在读取文件之前就已读取,因此没有环境变量的会话使用默认日志级别。- 沙箱运行时(gVisor、Kata)和 CRI-O 需要单独验证单文件挂载。
