HAMi 亮相 ContainerDays 新加坡 2026:从 GPU 共享到 AI Factory
ContainerDays & AI Context Singapore 2026 于 10 月 27 至 28 日在新加坡新达城会展中心举行,议题覆盖云原生、AI 基础设施与平台工程。HAMi Community Manager 宋净超(Jimmy Song)与 HAMi Contributor Reza Jelveh(两位均来自密瓜智能)带来了一场 Workshop 和一场技术分享,HAMi 还出现在大会的另外三场议程中。
Workshop:从零开始实践共享 GPU
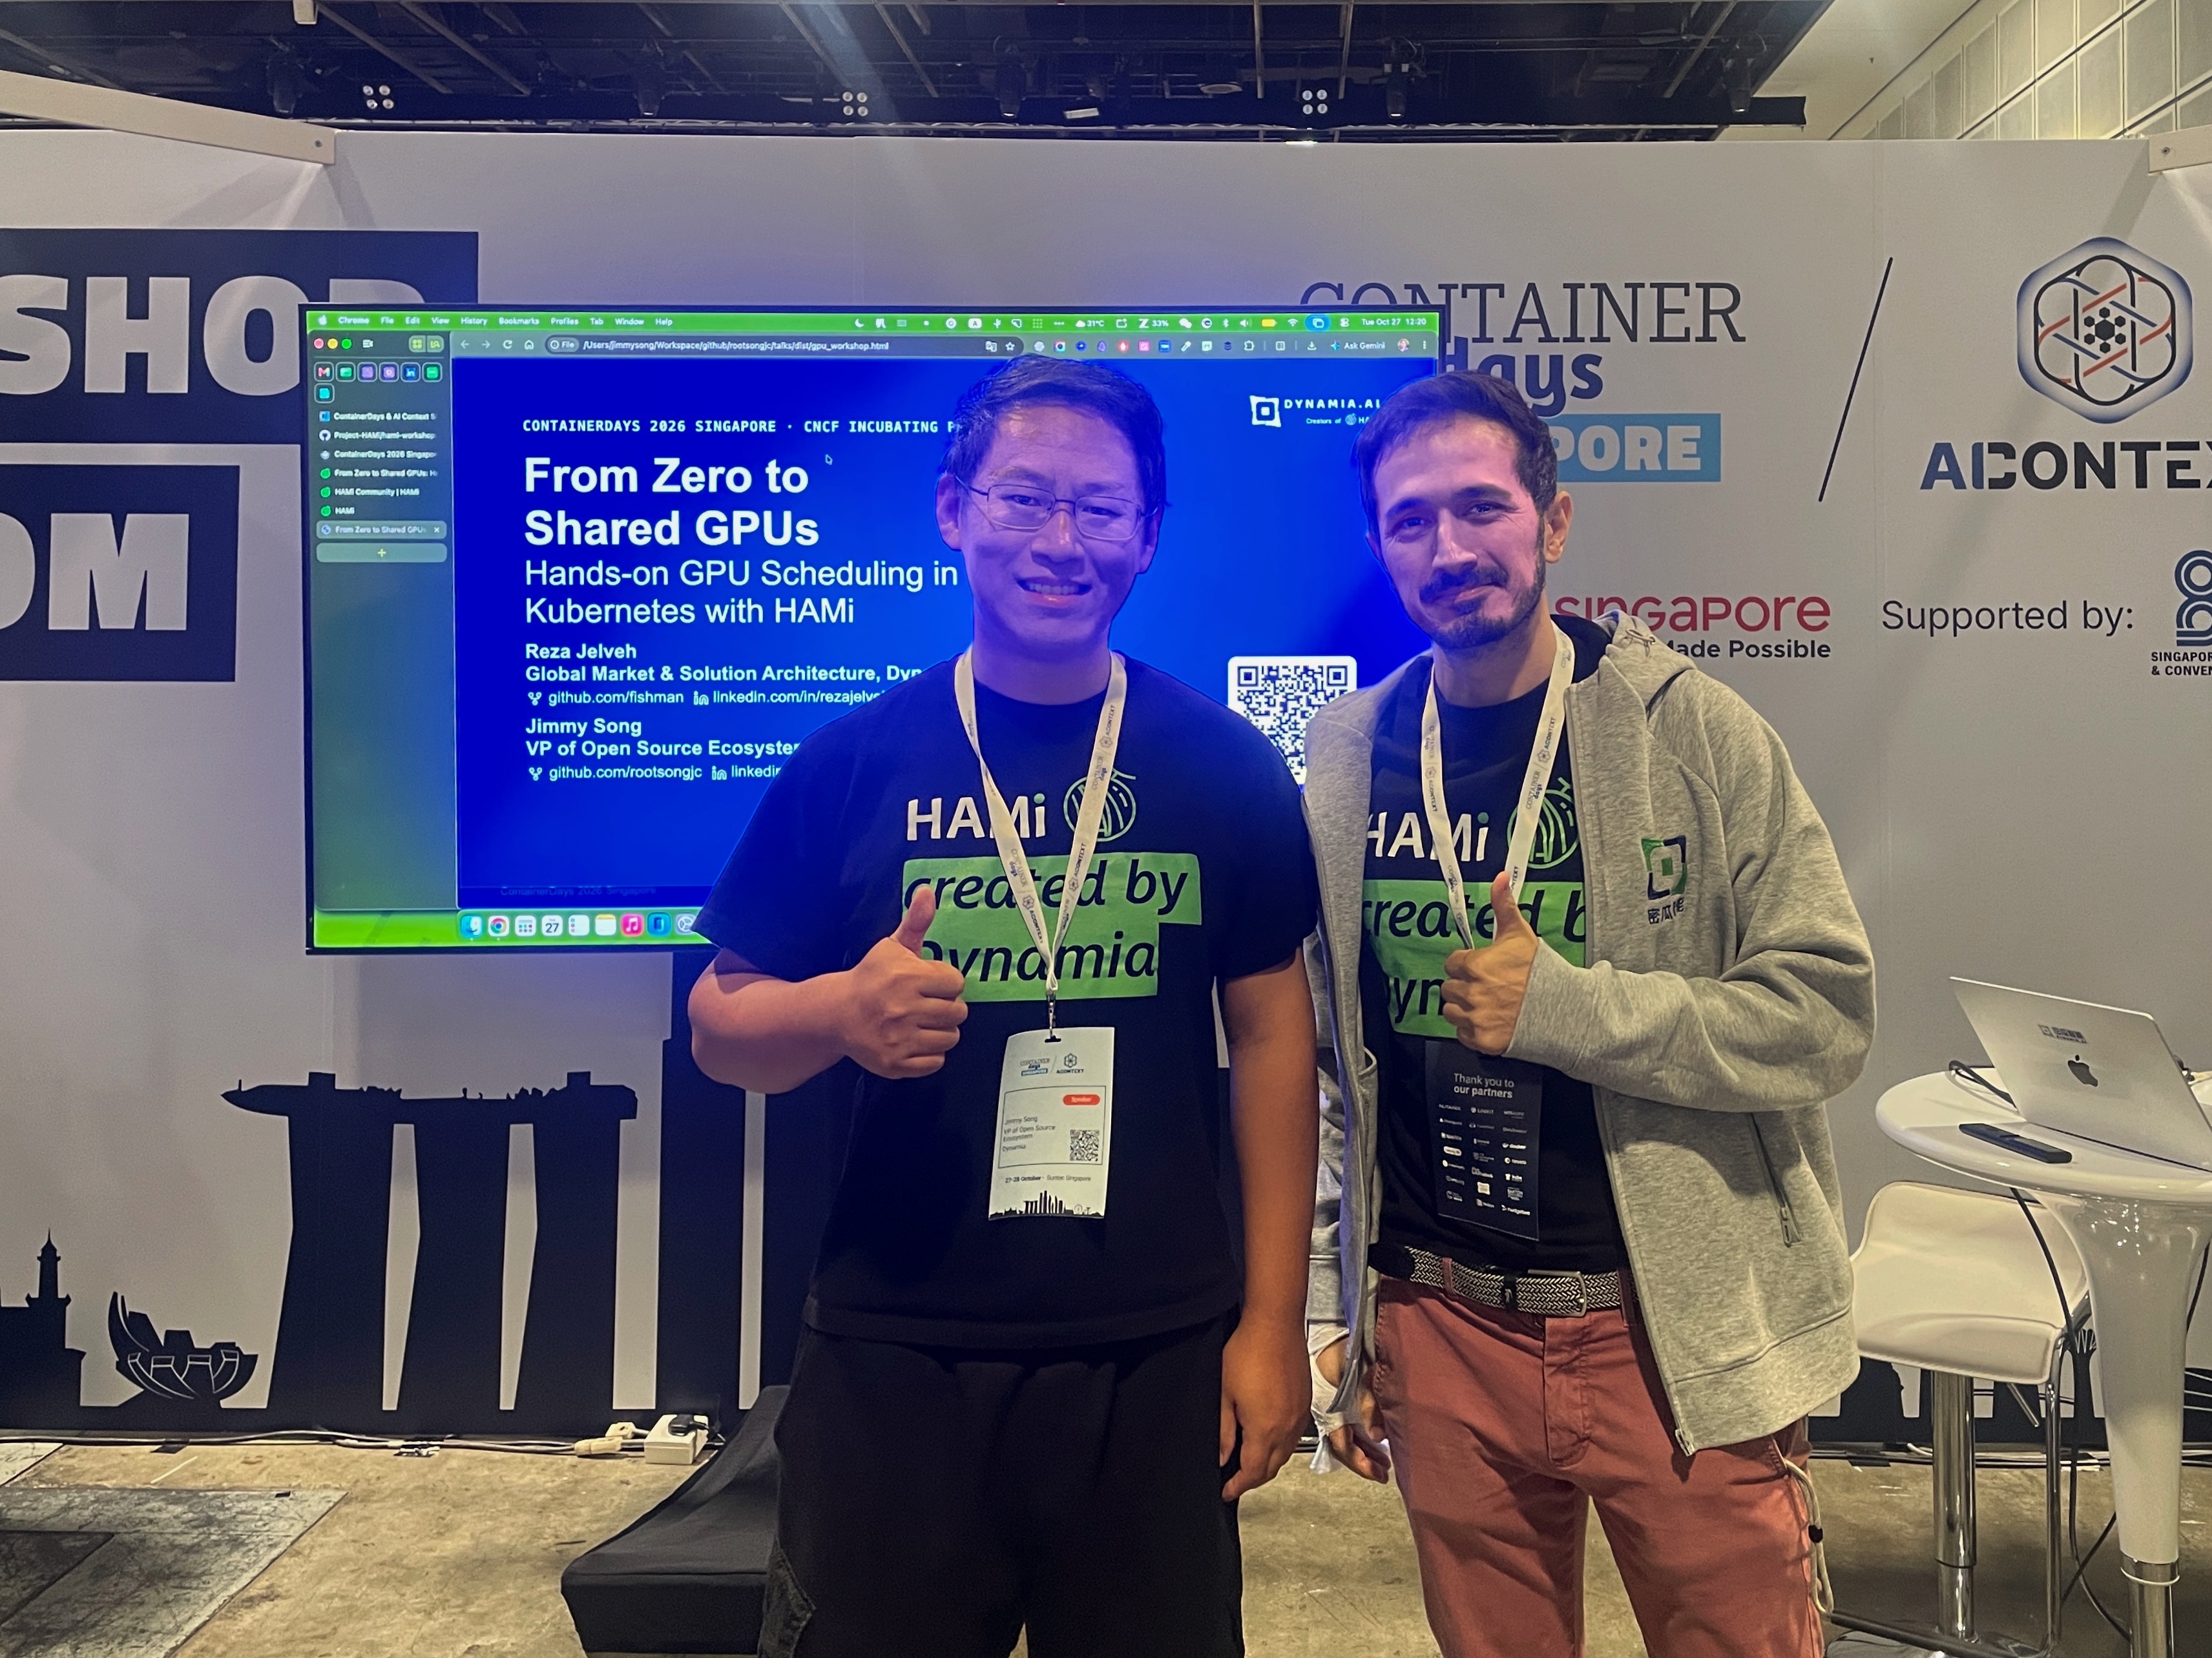
Workshop From Zero to Shared GPUs: Hands-on GPU Scheduling in Kubernetes with HAMi 通过基于 kind 的本地实验环境带领参与者实践 GPU 共享。实验使用模拟设备插件注册了两张虚拟的 NVIDIA A100-40GB,参与者无需物理 GPU,即可运行真实的 HAMi Scheduler,观察资源申请、设备选择与 Pod 调度的完整过程。
一组实验直观展示了调度中的关键问题:三个各申请 15,000 MB 显存与 30% 计算资源的 Pod 被分配到两张模拟 GPU 上,而一个申请 45,000 MB 显存的 Pod 始终处于 Pending 状态。即使两张卡的剩余显存之和能够满足请求,调度器也必须判断单个设备能否满足任务需求,而不仅是检查节点的空闲容量。
实验随后对比了 binpack 与 spread 两种放置策略的效果,并介绍了 HAMi 与 KAI Scheduler、Volcano 以及 Kubernetes DRA 的协作方式:无论选择哪种调度体系,都可以由 HAMi-core 提供运行时资源限制。模拟 GPU 适合验证调度逻辑,运行时隔离仍需在真实硬件上验证。
分享:让 Neocloud 的 GPU 利用率提升十倍
Reza Jelveh 的分享 10X Your Neocloud's GPU Utilization with HAMi 关注 Neocloud 平台的实际问题:当 GPU 需要同时服务多个租户和不同类型的工作负载时,如何减少资源闲置?
演讲引用的多组数据显示,不同团队的 GPU 利用率大多在 5% 至 20% 之间:一部分任务还在排队等待 GPU,已分配出去的 GPU 却没有被充分使用。一个只需约 1 GB 显存的时序推理任务,在整卡分配模式下仍可能独占一张 141 GB 的 H200。
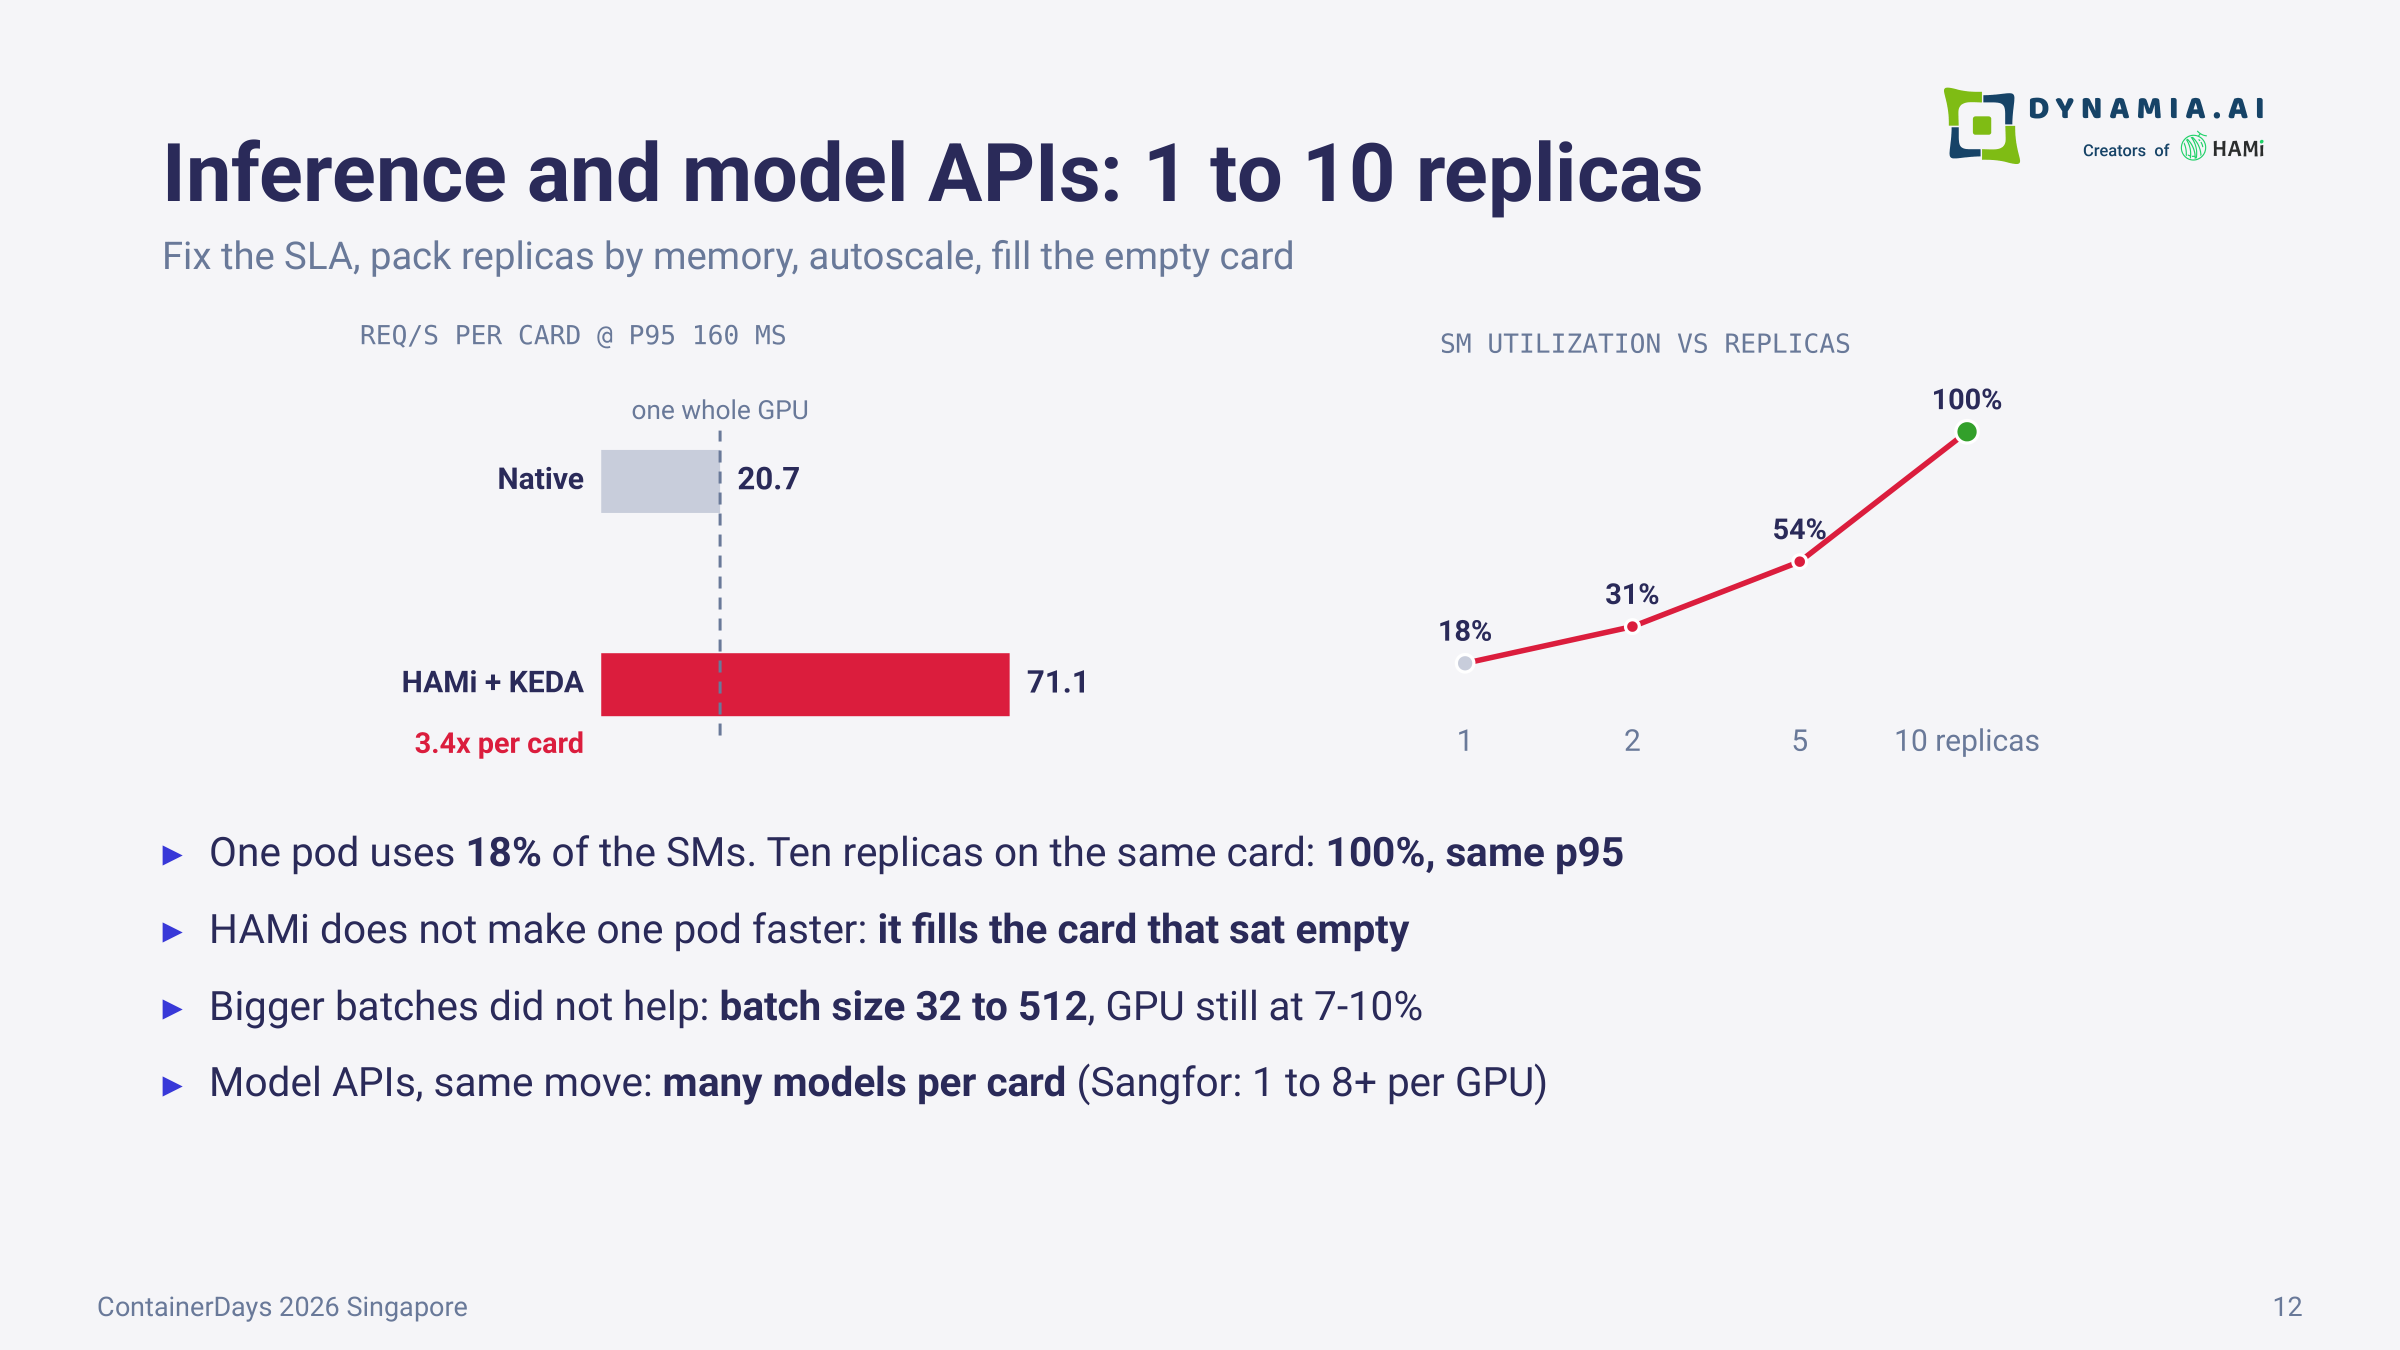
对于推理服务,在同一张卡上增加副本可以提升利用率:演示中,10 个副本的 GPU SM 利用率达到 100%,p95 延迟保持不变。标题中的“10X”并非对所有平台的承诺,实际效果取决于工作负载构成、资源配置与平台基线。大型训练任务通常保留整卡,不可信租户需要结合 MIG 或独占设备评估隔离要求;面对 AMD、昇腾等异构设备,HAMi 提供对应的资源管理与限制机制,并可与 Volcano、Kueue、KAI Scheduler 等协同。演讲还区分了 HAMi 的两类监控指标:Scheduler 暴露的资源分配指标(端口 9395)与 vGPUmonitor 暴露的资源使用指标(端口 9394)。
DRA 负责分配,谁来负责执行?
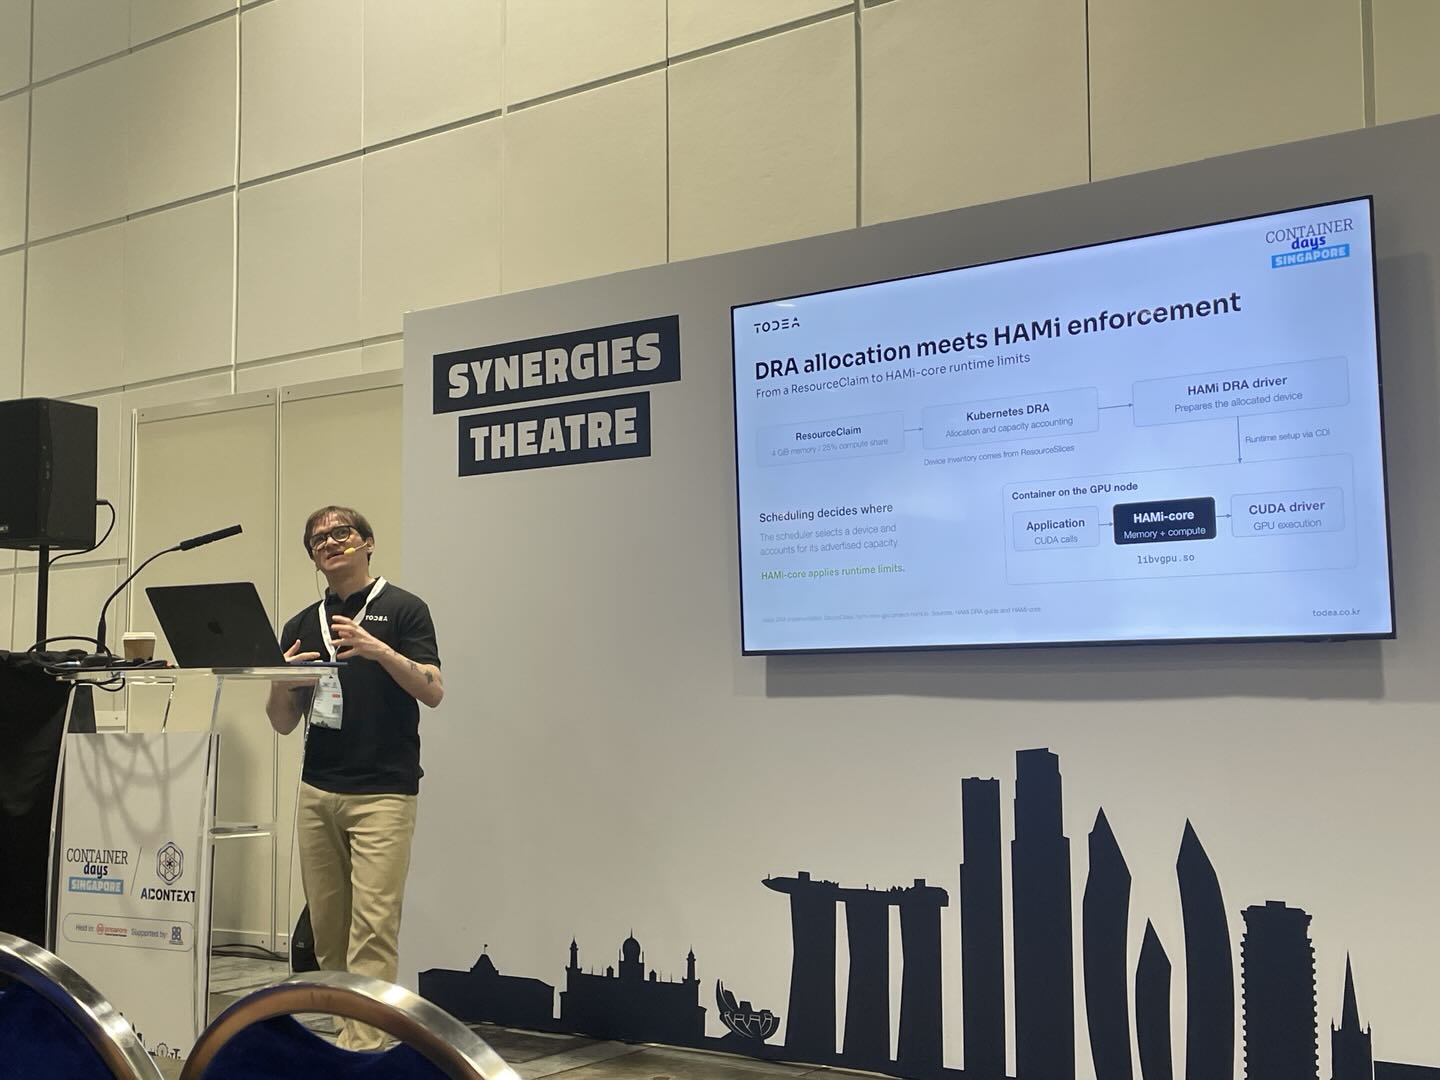
在 DRA Allocates, But Who Enforces? Closing the GPU Sharing Gap with HAMi 这场分享中,Ivan Porta(Todea)讨论了 DRA 的资源分配与运行时限制之间的衔接问题。DRA 可以通过 ResourceClaims 描述和分配设备,但 Kubernetes API 本身并不会阻止容器在运行时超出 GPU 资源额度。
演讲介绍了 HAMi 各组件如何补足这一环节:Mutating Webhook 调整调度相关信息,Scheduler Extender 参与调度决策,Device Plugin 负责设备注册与分配,HAMi-core 在容器运行时拦截 CUDA 调用并执行显存与计算资源限制。HAMi-DRA 还可以将 nvidia.com/gpu 资源请求转换为 DRA ResourceClaims,在保持 Pod 资源接口稳定的同时,让底层资源管理方式随 Kubernetes 环境演进。
人人都会构建 AI Factory 吗?
Saiyam Pathak(vCluster Labs)分享了从个人电脑上的单张 GPU 到企业级 AI Factory 的演进路径。现场演示让多个团队各自隔离的 Kubernetes 集群与推理工作负载运行在同一张 GPU 上,其中使用了 vCluster 与 HAMi 等开源项目。
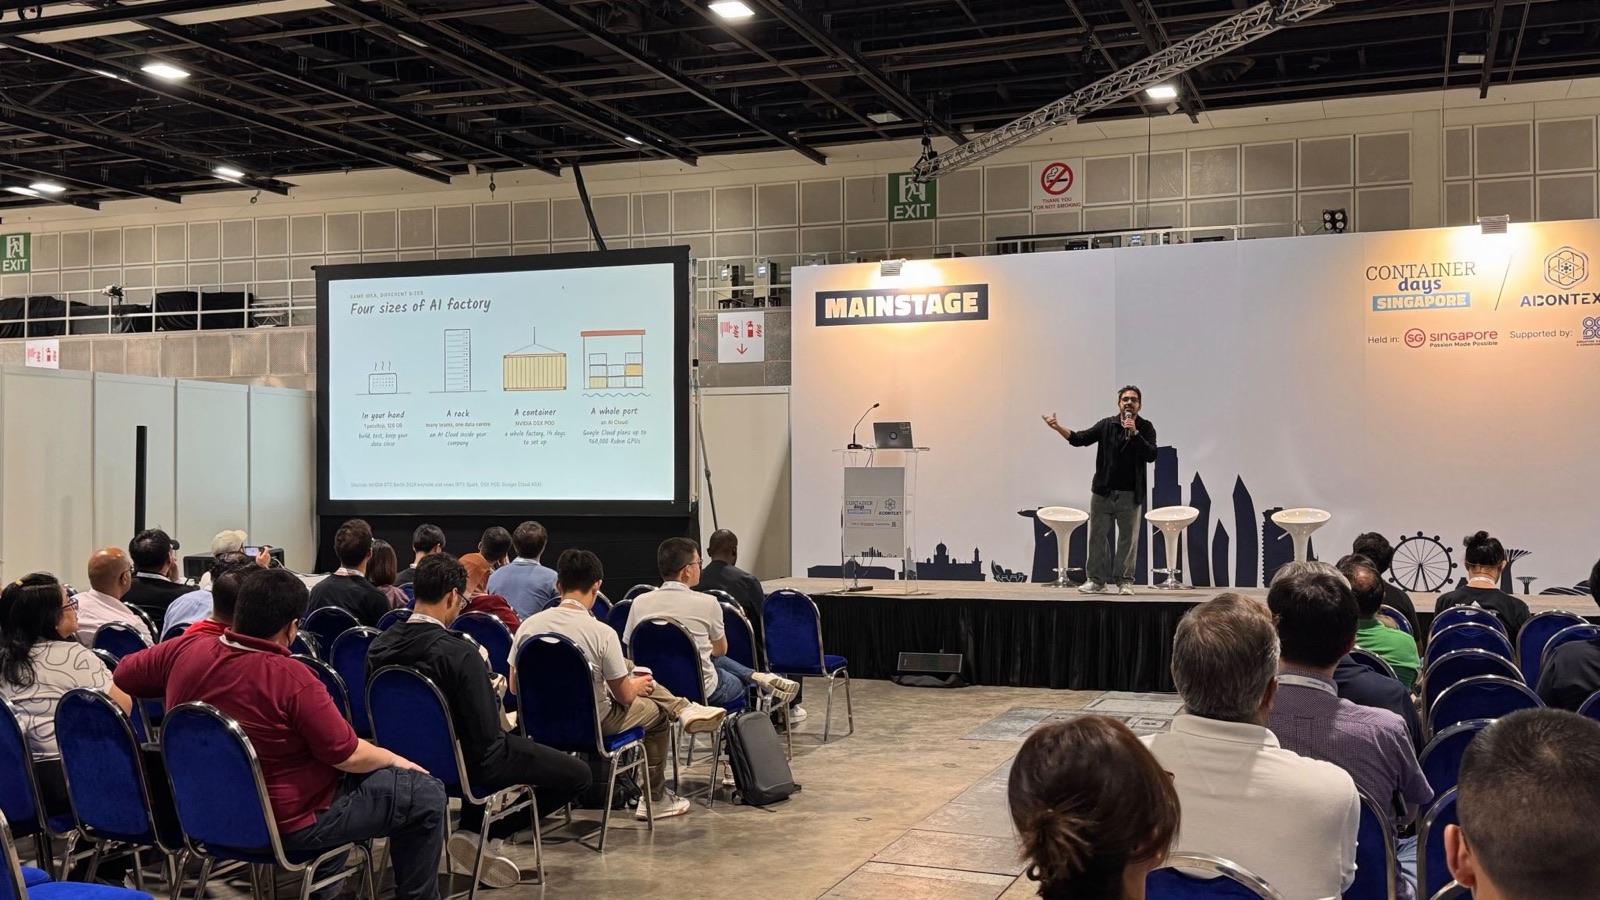
这场分享的要点在于:AI Factory 不只是把更多 GPU 集中起来,而是通过软件平台将硬件组织为可管理的计算环境,其中 Kubernetes 负责工作负载编排,GPU 共享让有限的加速计算资源服务更多团队。
从云原生到 AI 原生
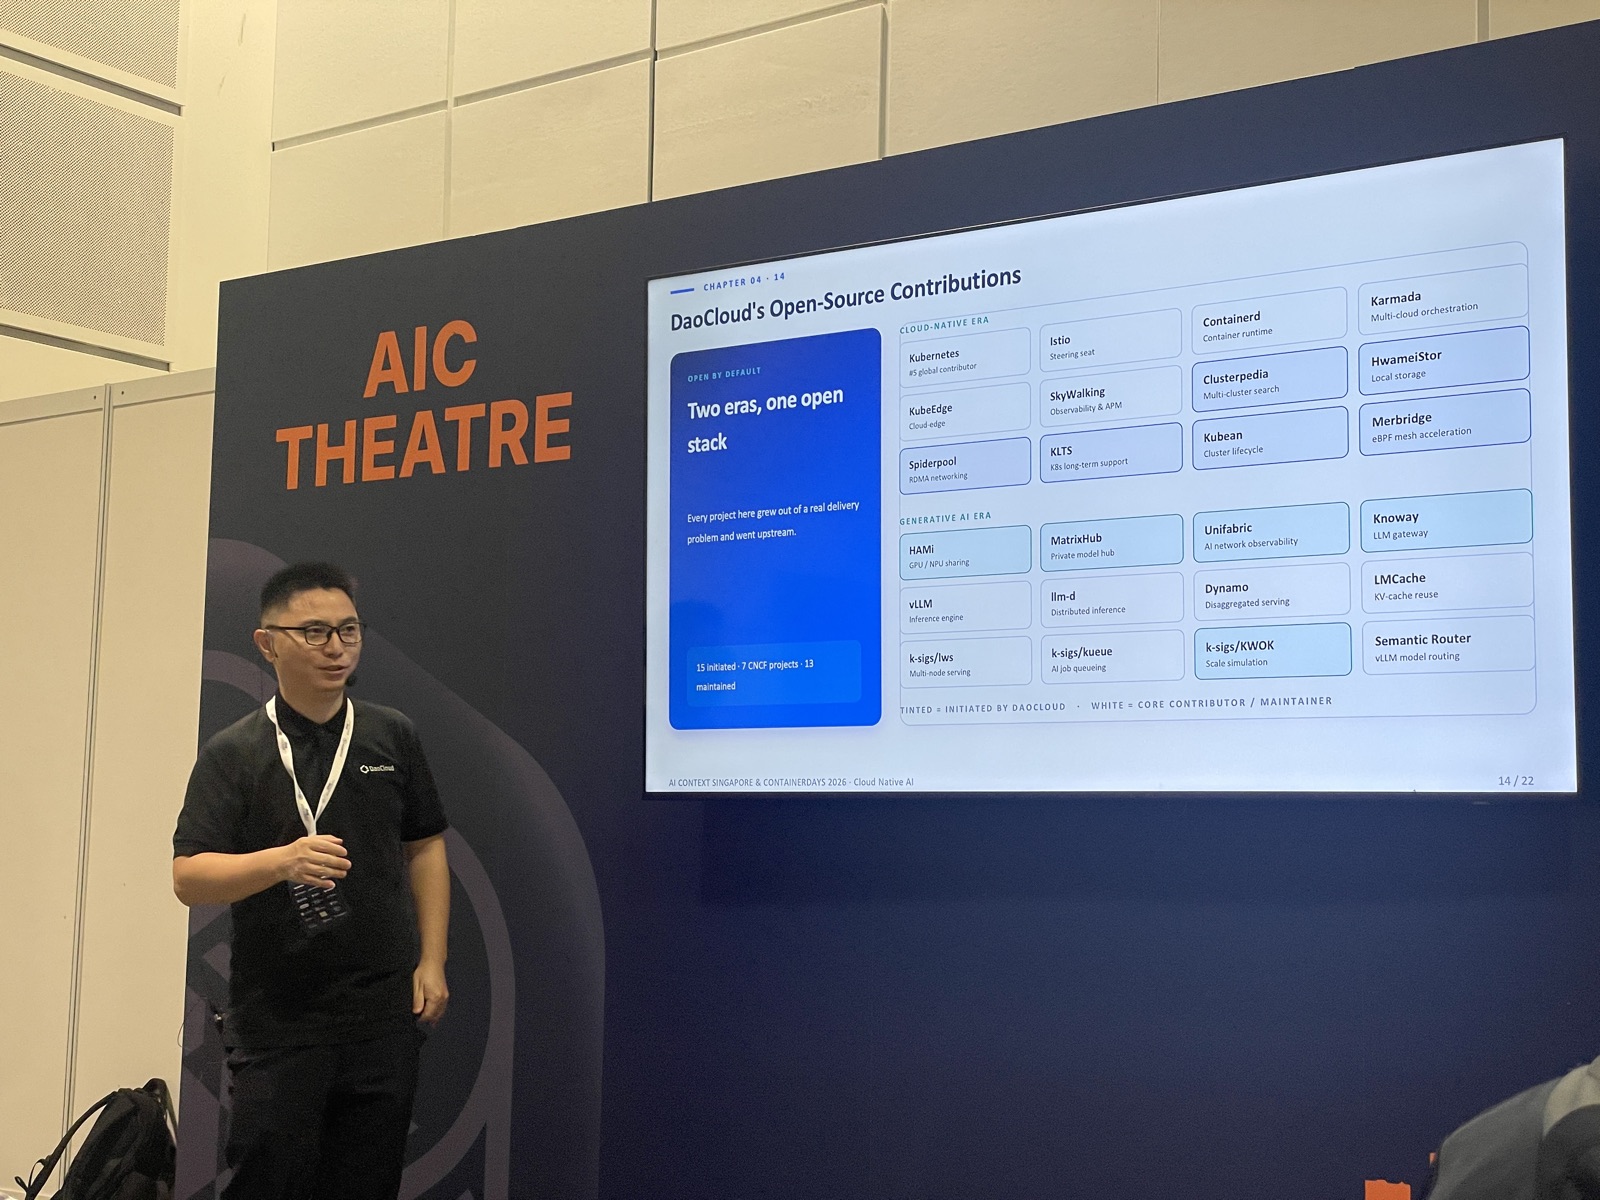
Xu Chen(DaoCloud)讨论了东南亚数字化转型中从云原生应用现代化走向 AI 原生平台建设的路径,内容涵盖开放式 Cloud-Native AI 平台与开源生态的作用。HAMi 作为 Kubernetes 中异构计算设备共享与管理的项目被纳入这一技术版图,与其他云原生组件共同支撑 AI 工作负载。
共同的主线
五场分享切入的角度不同,但反复回到同样的问题:资源如何分配、运行时如何执行限制、调度策略是否适合工作负载,以及平台能否同时观察资源的分配情况与实际使用情况。
GPU 共享不是所有工作负载的统一答案,切分粒度也并非越细越好。选择资源分配方式,需要结合任务特点、性能目标、隔离边界与平台整体利用率综合判断。
HAMi 社区将继续围绕 GPU 共享、异构算力管理、Kubernetes 调度与运行时隔离开展探索。欢迎访问社区页面或 HAMi 仓库参与协作。
